1. llm-dではないものから確認する
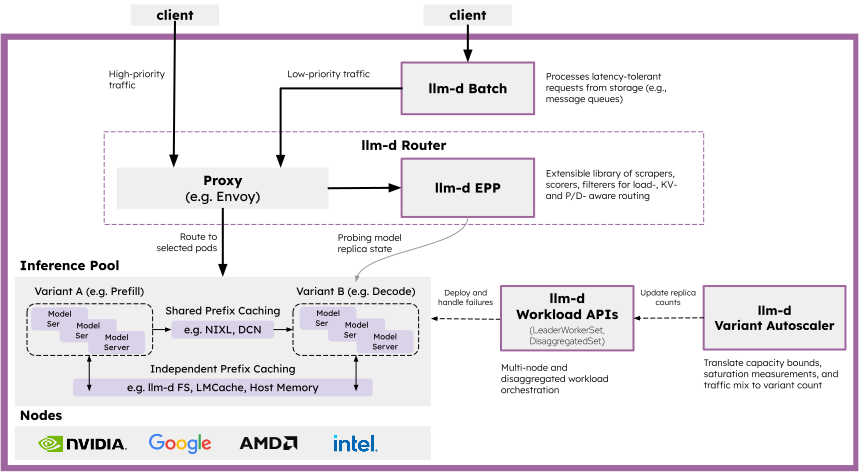
llm-dは言語モデルでも、vLLMやSGLangを全面的に置き換えるエンジンでも、消費者向けAPIでもない。モデルサーバーとKubernetesの上で要求を受け、宛先、KVキャッシュ状態、サービング群を調整するオープンな層だ。
回答品質で閉鎖モデルと比べるのではなく、一般的な負荷分散と固定GPUプールの現行構成を、文脈・負荷・優先度を理解する制御層と同じ負荷で比べる。
2. 1.0がDay 2運用に加えたもの
安定したv1設定API、優先度と公平性を考慮するフロー制御、prefill/decode群の連動更新、セッションキャッシュを活用するルーティングが中心だ。
ただし無停止は自動保証ではない。正しい高可用構成、障害試験、版の互換性、可観測性が要る。「エージェント対応」もセッション運用の改善であり、エージェント判断の品質保証ではない。
3. なぜprefillとdecodeを分けるのか
長い入力を読むprefillは計算負荷が高く、後続トークン生成はメモリと帯域の制約を受けやすい。別々のプールを設けKV状態を転送すれば、段階ごとに拡張できる。
代わりにデータ移動、ネットワーク依存、両側の版管理が増える。小規模・短文脈なら単純構成が有利な場合もある。1.0は分離を運用しやすくするが、万能にはしない。
4. 性能値は購入保証ではなく試験例として読む
プロジェクトはキャッシュ認識ルーティングでラウンドロビン比3倍の出力スループットなどを報告する。各値はモデル、加速器、同時数、文脈、基準条件に依存する。AI World Signalは再現していないため、プロジェクトとパートナーの結果として区別する。
実際の入出力長、接頭辞再利用、同時実行、優先帯、初回トークン目標を再生し、平均だけでなく障害と更新も測る。
5. 判断例:いつ試験する価値があるか
4GPUで単一モデル、安定負荷、短いセッションなら複雑さが先に増える可能性がある。複数テナント、長文脈エージェントの急増、無停止更新、異種機器が課題なら限定パイロットが合理的だ。
1週間の基準値を保存し代表負荷で比較する。成功はHelmの導入完了ではなく、遅延と費用目標、制御された障害、文書化したロールバックを同時に満たすことだ。